

ИИ будут обучены на работах российских ученых советского периода
В России будет оцифровано советское научное наследие, чтобы обучать на нем отечественные ИИ-модели. Это значительно расширит возможности ученых и обеспечит прогресс в российской науке.

В государственной базе сейчас находится около 1,5 миллиона статей и других научных материалов советского периода, но в архивах их более 2 млрд. 600 миллионов из них скоро пополнят общую базу.
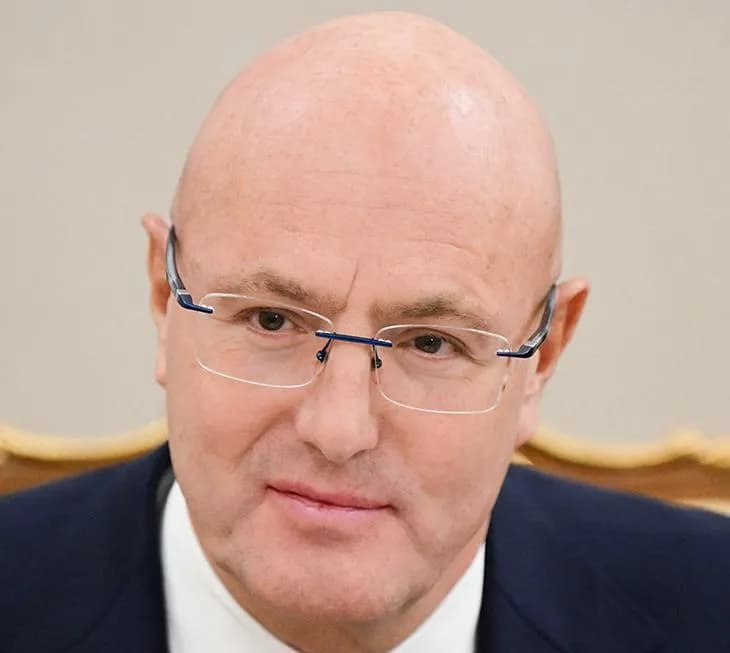
«Мы переводим в цифру фонды государственной системы научно-технической информации. И главная задача – оцифровать все наше советское наследие. Все это для того, чтобы обучать наши суверенные модели искусственного интеллекта», – рассказал вице-премьер России Дмитрий Чернышенко.

ИИ-сервисы для науки
Качество и объем обучающих данных являются одним из ключевых факторов развития современных ИИ-технологий наряду с вычислительными мощностями и алгоритмами. Теперь в России появится уникальный корпус научных знаний, который позволит создавать ИИ-сервисы для науки, инженерии, образования и промышленности. Проделанная работа позволит усилить позиции российских учёных и расширить спектр задач, которые можно решать с помощью ИИ.
После оцифровки ученые, инженеры, преподаватели и студенты получат более удобный доступ к научным материалам. На базе новых ИИ-моделей могут появиться интеллектуальные поисковые системы для научной информации, инструменты анализа публикаций и автоматизации подготовки исследований.
Таким образом, в стране создается фундаментальная инфраструктура для российских ИИ-разработок. В будущем могут появиться научные ИИ-ассистенты, которые будут помогать исследователям искать взаимосвязи между научными работами, анализировать архивные публикации и формировать новые гипотезы. Использование OCR, семантического поиска и анализа документов позволит превратить архивы в машиночитаемые базы знаний.

Цифровизация дошла до архивов
В 2022 году Федеральное архивное агентство запустило цифровую трансформацию: создало платформу хранения электронных документов и начало перевод материалов в цифровой формат. Планировалось создание информационной системы удаленного использования архивных документов с применением ИИ для поиска. Это стало началом подготовки российских архивных массивов к использованию технологий искусственного интеллекта.
Затем в 2023 году компания «Яндекс» запустила сервис «Поиск по архивам», который использует нейросети для распознавания исторических документов и перевода рукописных материалов в машиночитаемый вид. Сервис развивается, а оцифровка новых документов расширяет доступ к объему информации.
Параллельно началась оцифровка библиотечных фондов и старых газет. В 2025 году «Яндекс» совместно с газетой «Известия» и Национальной электронной библиотекой представил цифровой архив издания. С помощью нейросетей были обработаны более 30 тысяч выпусков газеты за период с 1917 по 2024 год. Все это показывает, что ИИ стал незаменимым помощником в работе с большими массивами библиотечных и архивных данных.

База для выхода на новый уровень
Оцифровка советского научного наследия – это переход от традиционного хранения архивов к созданию национальной базы знаний для искусственного интеллекта. Самое главное в этом проекте – дать знания в формате пригодном для обучения алгоритмов.
ИИ активно используется российскими учеными, но пока его знания ограничены. Нужно обогащать общую базу для качественного обучения ИИ-моделей. В перспективе такие базы данных станут основой для специализированных российских ИИ-систем в науке и помогут вывести ее на еще более высокий уровень.