

Цифровые инструменты помогут изучить этикет
Преподаватель из Чеченской Республики создала цифровую базу с 2300 этикетными единицами и разработала модель для их описания. Материалы помогут вести себя культурно в любых ситуациях, учитывая их контекст и компанию, в которой вы оказались.
Наше поведение в обществе и выбранные слова зависят от ситуации и собеседников, а также культурных традиций. Быть уместным и вежливым в разных ситуациях поможет цифровая база знаний по этикету.
Более двух тысяч правил этикета
Старший преподаватель Чеченского государственного педагогического университета Эльмира Хамутаева более 20 лет собирала материалы по чеченскому речевому этикету и объединила их в цифровом пространстве. Исследовательница собрала речевые конструкции из устного общения, художественной литературы, фольклора и современной цифровой коммуникации. Свою работу она представила на Международной молодёжной научной конференции «Культурно-языковое многообразие России в эпоху больших языковых моделей» в Москве.
«Накопленные за годы исследования материалы представлены двумя самостоятельными массивами. Первый – ранее сформированный рабочий словарный массив в Word объёмом около 200 страниц. Второй – отдельный цифровой массив в GoogleSheets, включающий 2300 новых этикетных единиц», – пояснили в вузе.
Параметрическая модель учитывает контекст
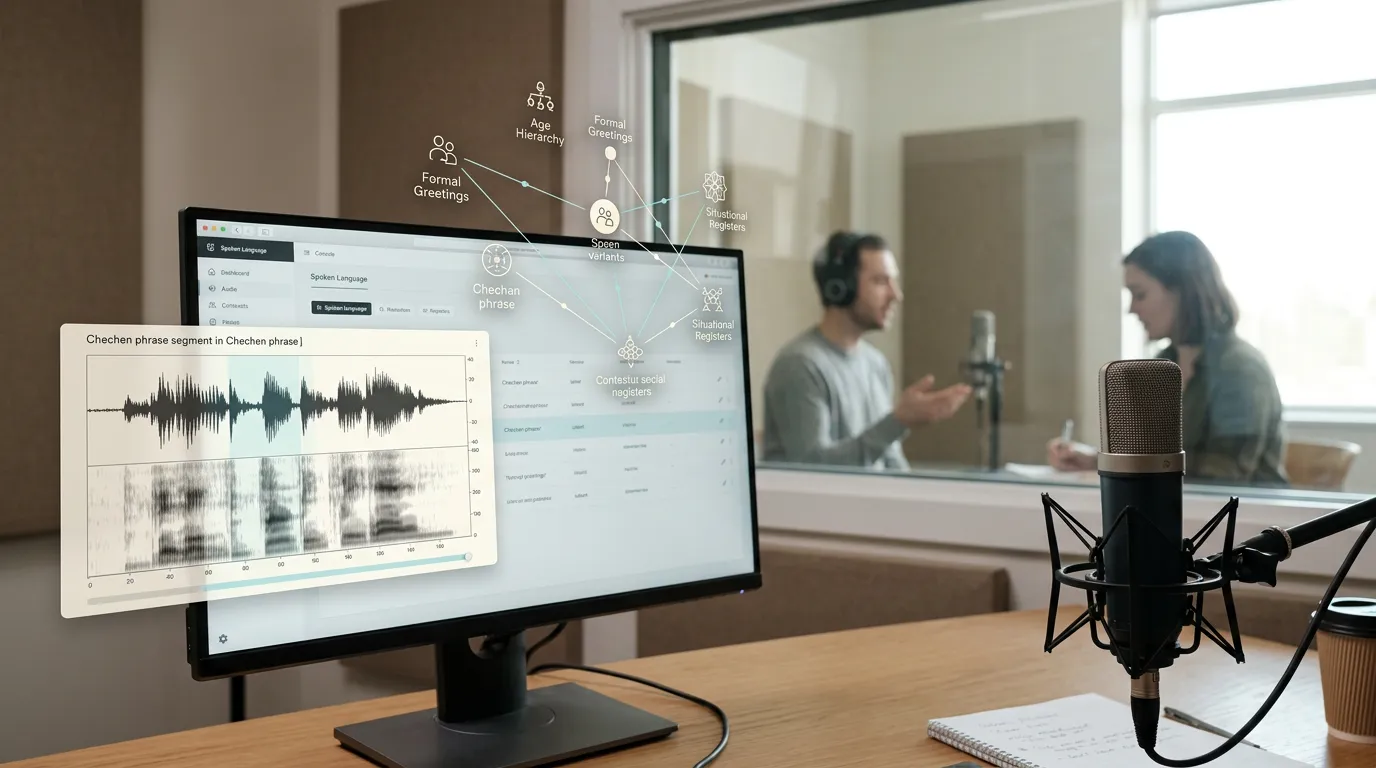
Для систематизации знаний была разработана параметрическая модель, она учитывает не просто некое правило или устойчивое речевое выражение, но и ситуацию его употребления, пол и возраст участников диалога, существующие ограничения, культурные особенности. Этикет предлагается изучать не абстрактно, а с учётом реальной коммуникативной ситуации, которая диктует, как именно людям стоит вести себя в зависимости от статуса и роли в диалоге.
Как рассказала Эльмира Хамутаева, следующим этапом исследования станет формирование связанной цифровой структуры данных. Она позволит сопоставлять этикетные единицы, их варианты и контексты употребления, выявлять устойчивые взаимосвязи между различными параметрами и использовать накопленные материалы как полноценный исследовательский ресурс.
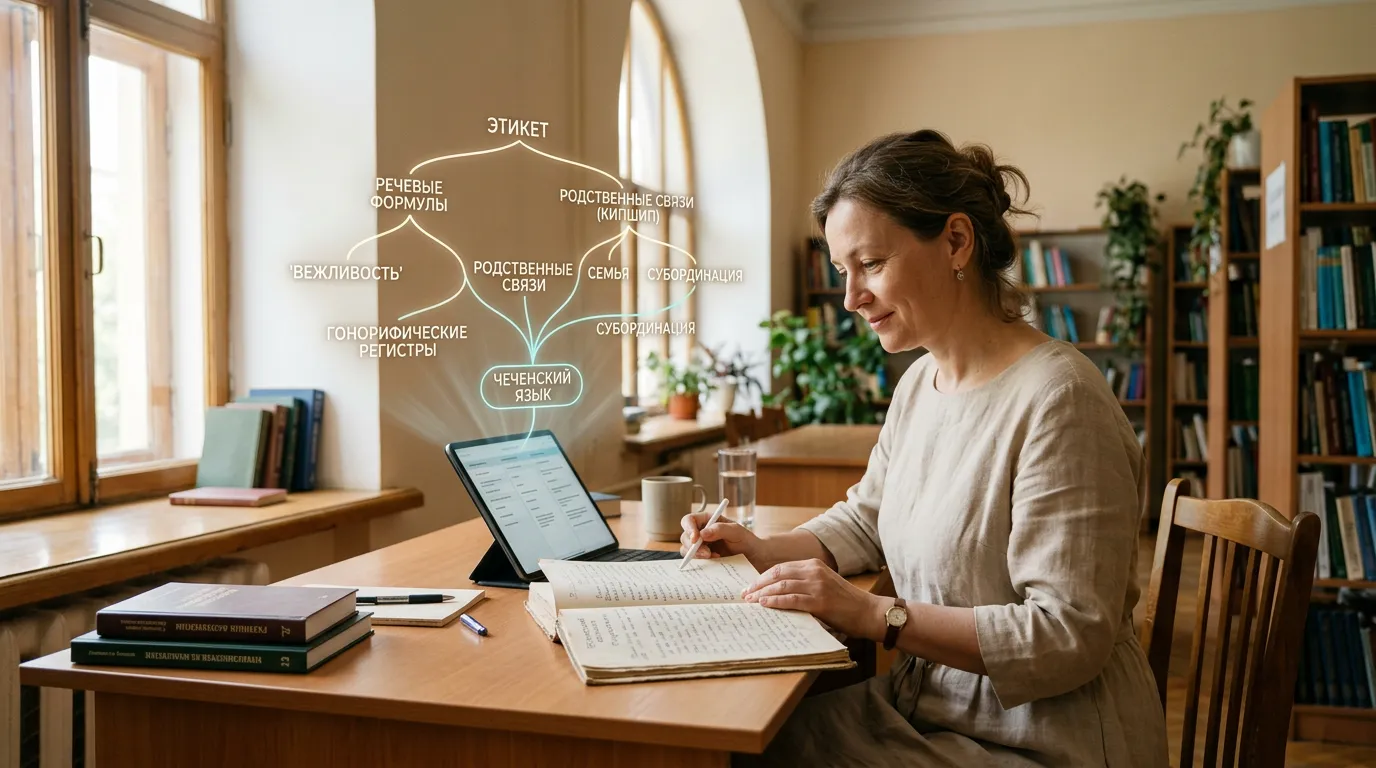
Работа расширяет возможности для систематизации и изучения чеченского языка с применением инструментов цифровой лингвистики. Именно за такими способами знакомства с речью, культурой и традициями – будущее современного общества.
Это не самостоятельный продукт вроде словаря или справочника по этикету. Ценность созданного ресурса – в цифровых данных. Подобные базы становятся исходным сырьём для электронных словарей, образовательных платформ, поисковых систем, машинного перевода, распознавания и синтеза речи, а в дальнейшем – для языковых моделей. В России уже есть подобный опыт: языковые корпуса, подготовленные научными и региональными организациями, уже используются «Яндексом» при добавлении языков народов России в «Яндекс Переводчик».
База для обучения нейросети
На основе собранных данных можно обучить нейросеть, это будет уже конкретный продукт, способный научить использовать речевые конструкции. Современные языковые модели должны не только понимать буквальное значение выражения, но и выбирать его в соответствии с социальным и культурным контекстом. Именно такие нюансы и помогает понять собранный массив данных.
Логичным развитием проекта Эльмиры Хамутаевой будет создание отдельного веб-ресурса или интеграция массива в существующую лингвистическую платформу с добавлением возможности поиска конкретной фразы для определенной ситуации. Российский опыт показывает, что именно объединение текста, метаданных и аудио впоследствии позволяет создавать системы распознавания речи, электронные словари и образовательные приложения. Для изучения речевого этикета особенно полезным будет добавление примеров диалогов.